几年前喊“AMD YES”,大家谈的是核数、价格和 EPYC。
到了 2026 年,问题已经往下走了一层:CPU 选了 AMD,VASP 的编译器、数学库和 FFT 是否也能沿着 AMD 生态搭起来?全套装好,实际性能又在什么位置?
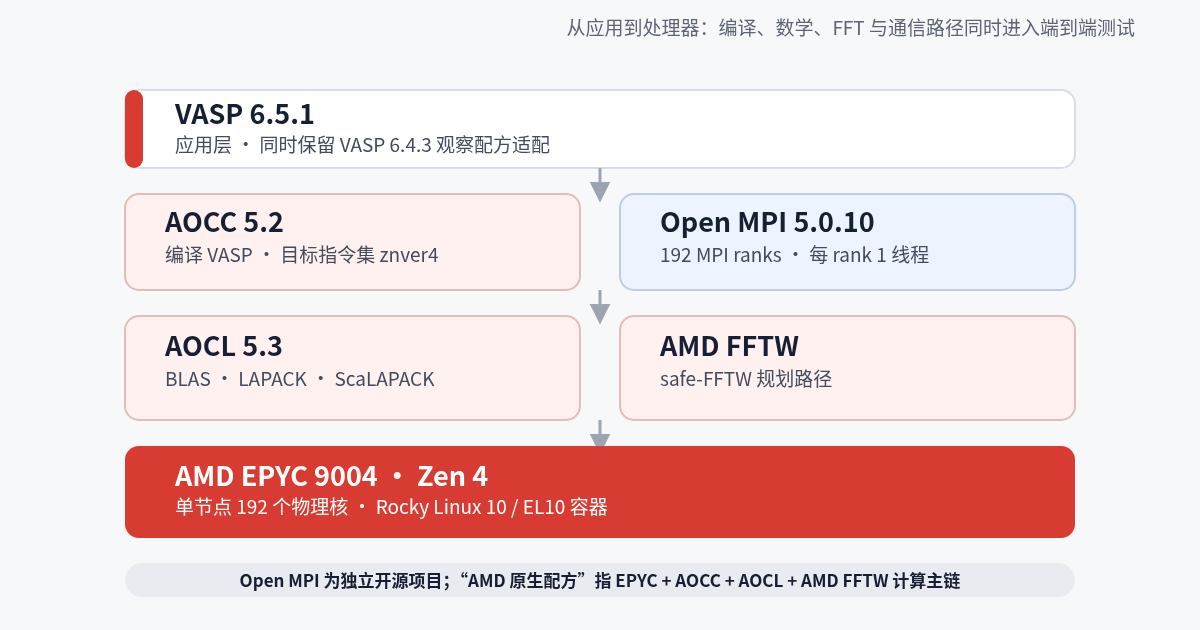
这次,我们把八套 VASP 软件配方装进同一台 Rocky Linux 10、192 核 AMD EPYC 9004 单节点上。对比8套工具链,帮你测试一下,AMD 这些年打造的 HPC 生态,到底是什么成色。
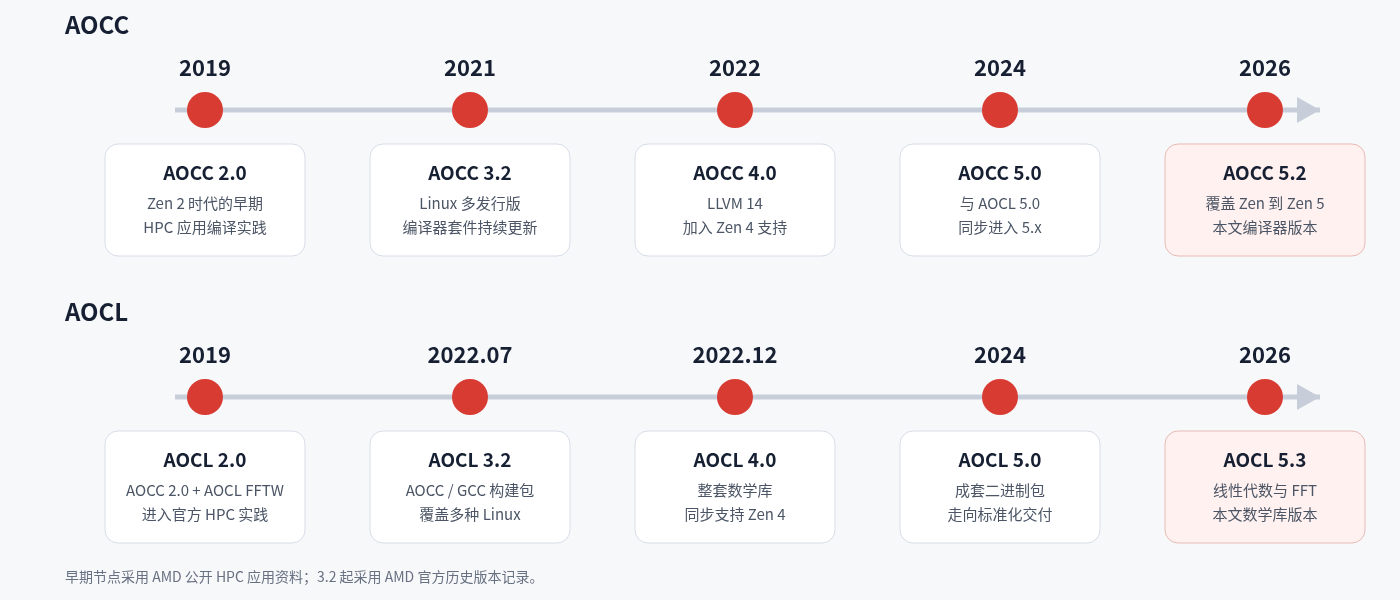
从Zen1问世开始,到AOCC第一代出现,AMD 发展至今,AMD YES 已经快10年了。不过大家都知道,VASP对AMD支持一直不能说是没有吧,不过也确实是能跑就行。
时间轴资料:AMD AOCC 历史版本、AMD AOCL 历史版本。
咱们本次测试就最新一代的AMD全家桶和相对新的VASP,终于用上真全家桶了, AMD YES!
znver4
运行环境采用 EL10 容器,192 MPI ranks,每 rank 1 线程。Slurm 分配资源后,由容器内的 Open MPI mpirun 启动作业。
mpirun
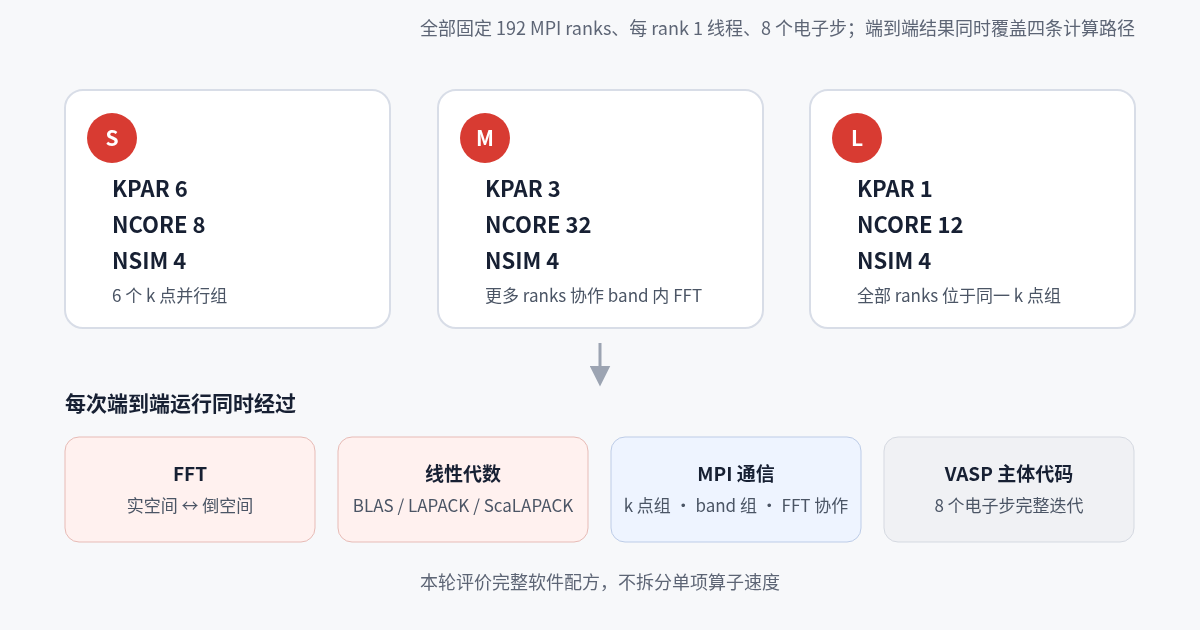
本轮直接跑完整 VASP 电子迭代,让编译器、数学库、FFT 和 MPI 通信一起交卷。
三类负载都固定运行 8 个电子步,差别来自 KPAR 和 NCORE 组成的三种并行形状。
KPAR 负责分配 k 点,NCORE 决定多少 MPI ranks 一起处理 band 内的 FFT,NSIM=4 让多个 bands 同时推进。VASP KPAR,VASP NCORE,VASP NSIM
说得简单一点:这轮比的是整套 VASP 软件装好以后,真实计算跑得怎么样。
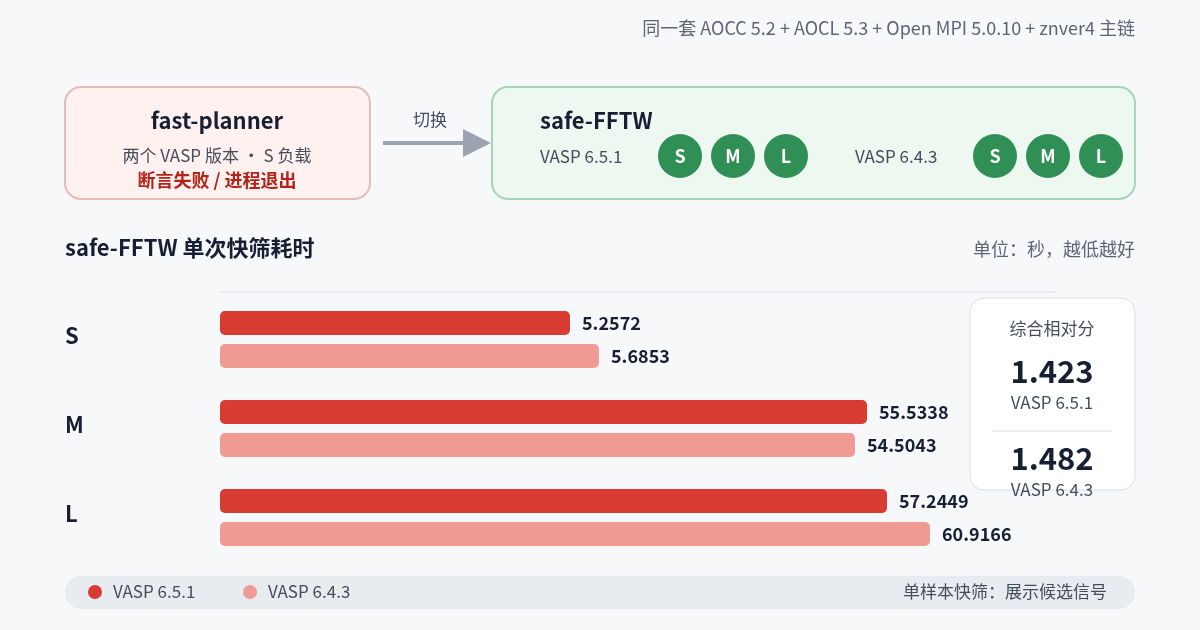
刚开始跑就报错,AMD FFTW fast-planner 在 S 负载触发 assertion,VASP 6.5.1 和 VASP 6.4.3 报 SIGABRT 中止。
调整了一下,关闭 fast-planner,切换到 safe-FFTW。AOCC 5.2、AOCL 5.3、Open MPI 5.0.10 和 znver4 全部保持原样,启动方式继续使用容器内的 mpirun。
重新编译之后,测试一切正常,两个 VASP 版本都完成了 S/M/L 三类任务。VASP 6.5.1 的耗时为 5.2572、55.5338、57.2449 秒;VASP 6.4.3 为 5.6853、54.5043、60.9166 秒。
看着好像好的很,接下来我们测一下Oneapi
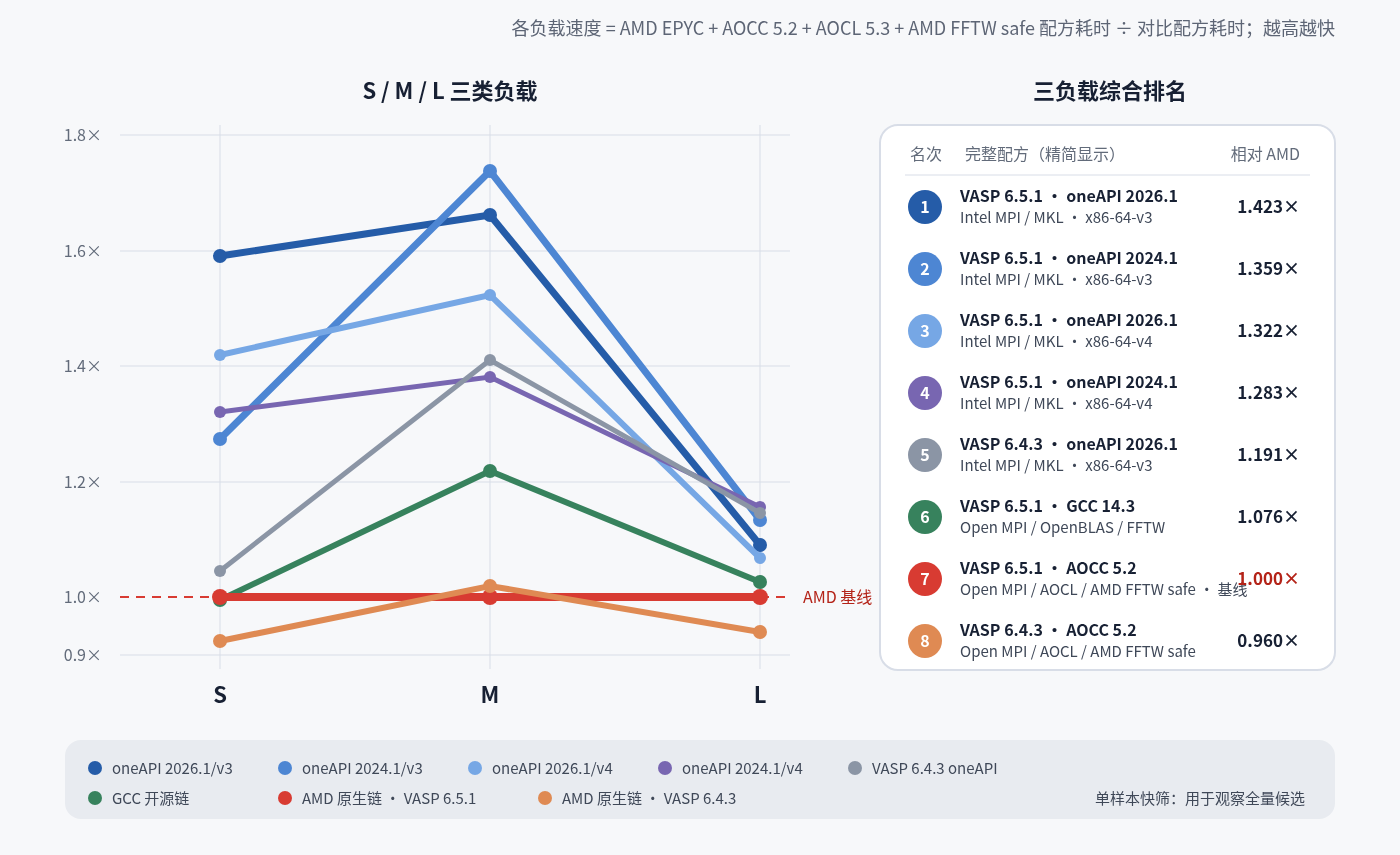
为了让差距一眼可见,我们把 VASP 6.5.1 的 AOCC 5.2、AOCL 5.3、AMD FFTW safe 配方设为 1.00× 基线。其他配方的数字表示相对这套 AMD 原生链的速度,越高越快。
惨败!我按照VASP官方指南来的,竟然
oneAPI 组合占据快筛前五,GCC 开源链排第六,两套 AMD 原生链排第七和第八。
这张图来自单次快筛,每套配方、每类负载各跑一次。
快筛前三全部来自 oneAPI、Intel MPI 和 MKL。
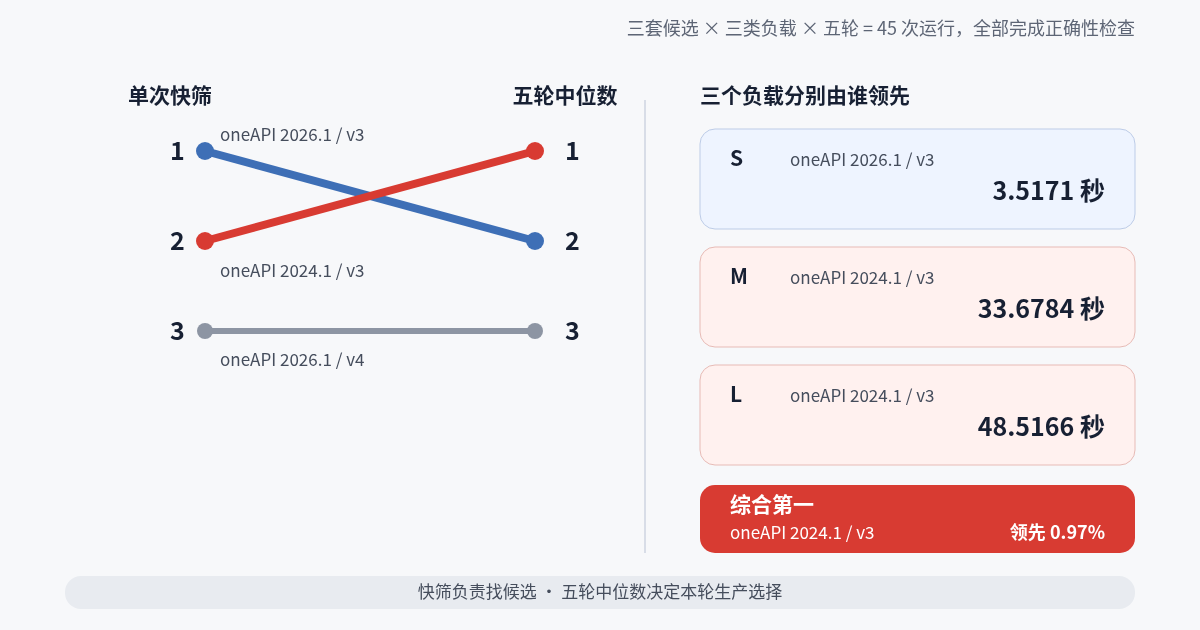
单次快筛时,oneAPI 2026.1、x86-64-v3 排第一;oneAPI 2024.1、x86-64-v3 排第二。随后,三套候选分别在 S/M/L 上运行五轮,共 45 次,全部完成正确性检查。
oneAPI 2026.1、x86-64-v3 赢下 S;oneAPI 2024.1、x86-64-v3 赢下 M 和 L,并以 3.7243、33.6784、48.5166 秒的三负载中位数取得综合第一。
第二名相对落后 0.970234%。
于是出现了这轮测试最有意思的一幕:oneAPI 软件栈先在 AMD 主场堂堂击沉 AMD 全家桶,随后 oneAPI 2026.1 又被 oneAPI 2024.1 反超。
冠军是 OneAPI 2024.1 !
AMD EPYC YES !不过AOCC从一开始的完全跑不了到现在,也是完全能用了,只能说是大进步吧。
最快配方是:
VASP 6.5.1 + oneAPI ifx 2024.1.0 + Intel MPI 2021.12 + Intel MKL 2024.1.0 + x86-64-v3。
本文数据来自 Rocky Linux 10、AMD EPYC 9004。
© 慧为计算。本文内容及图表版权归慧为计算所有。转载须注明作者及原文链接;商业转载或内容改编请联系 office@cshuiwei.com。
科学计算解决方案 →
高性能计算集群设计 →
联系技术顾问 →
慧为计算机致力于提供合理的高性能计算应用解决方案及IT集成项目建设的咨询。我们将面向客户提供一流的售前售后服务与可靠的产品质量。
©Copyright 2022. 长沙慧为计算机科技有限公司.